Nvidia : l’avantage se déplace au-delà du GPU avec Vera Rubin
Depuis trois ans, le récit dominant sur Nvidia tenait en une ligne : l’entreprise vendait les seules cartes graphiques capables de faire tourner l’IA à grande échelle, et cette exclusivité valait de l’or. Puis les géants du cloud ont commencé à concevoir leurs propres puces, et les investisseurs se sont demandé combien de temps l’avantage tiendrait. Depuis la publication des résultats trimestriels du groupe, mercredi dernier, une lecture différente s’impose : le véritable fossé creusé par Nvidia ne se situe plus dans le GPU lui-même, mais dans tout ce qui l’entoure. Explications.
Le GPU n’est plus le seul terrain de jeu
Rappelons d’abord de quoi l’on parle. Un GPU (processeur graphique) est une puce conçue à l’origine pour le jeu vidéo, mais dont l’architecture massivement parallèle s’est révélée idéale pour entraîner et faire fonctionner des réseaux de neurones. C’est ce composant qui a fait exploser la valorisation de Nvidia, multipliée par dix entre le début de l’année 2023 et le milieu de 2025.
Depuis un an, la trajectoire boursière est nettement plus calme. La raison est connue : Amazon, Google et d’autres opérateurs de centres de données conçoivent désormais leurs propres accélérateurs, et la concurrence sur le silicium pur s’intensifie. La question posée par le marché était donc légitime : que reste-t-il à Nvidia quand le GPU devient une marchandise comme une autre ?
La réponse tient dans un mot peu spectaculaire mais décisif : l’orchestration. Lorsqu’un centre de données atteint l’échelle du gigawatt, faire fonctionner l’ensemble à son rendement maximal devient un problème d’ingénierie autrement plus complexe que celui de la puissance de calcul brute.
Vera Rubin, ou la voiture complète plutôt que le moteur seul
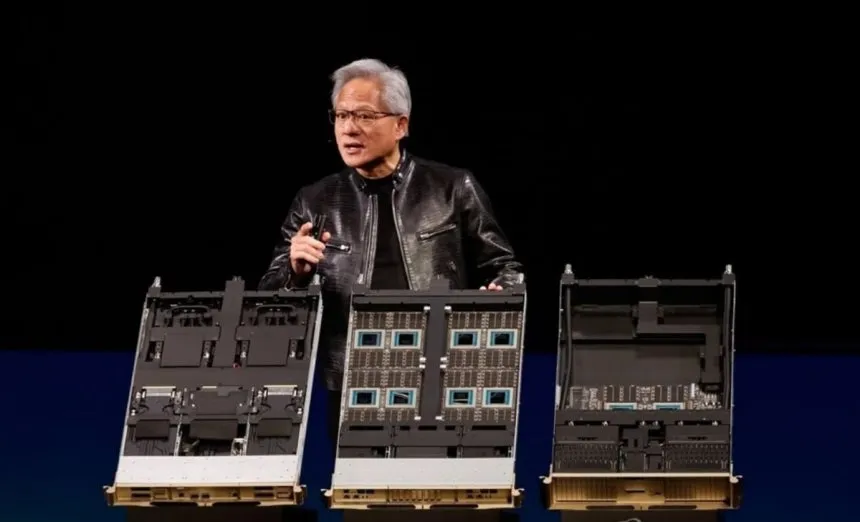
Nvidia déploie actuellement son architecture Vera Rubin. Le nom recouvre bien plus qu’un processeur : il associe le GPU Rubin à un ensemble d’unités spécialisées, parmi lesquelles le processeur central Vera, un accélérateur d’inférence désigné LPX par le constructeur, ainsi que des baies dédiées au stockage et au réseau.
La métaphore employée par TechCrunch est parlante : si le GPU est le moteur, ces éléments constituent le reste de la voiture. Ils ne produisent pas de jetons de calcul, ils s’assurent que tout ce qui gravite autour du GPU fonctionne sans gaspillage.
Le processeur Vera illustre parfaitement cette logique. Sa fonction principale n’est pas de calculer mais de diriger la circulation des données. « Vera est important parce qu’il n’y a qu’une quantité limitée de mémoire que l’on peut installer dans un serveur, ou dans n’importe quelle plateforme de calcul », explique Jason Hardy, vice-président chargé des technologies de stockage chez Nvidia.
Le problème est concret. La capacité mémoire des centres de données a augmenté au même rythme que leur puissance de calcul, ce qui a d’ailleurs enrichi les fabricants de mémoire lors de la deuxième vague du boom des infrastructures. Mais disposer de la donnée ne suffit pas : encore faut-il l’acheminer au GPU au bon moment. Faute de quoi, un processeur facturé plusieurs dizaines de milliers de dollars passe une partie de son temps à attendre.
Selon Jason Hardy, l’accélération apportée par le processeur Vera atteint jusqu’à trois fois sur ces opérations d’acheminement. « Nous pouvons désormais exploiter notre mémoire flash à son plein potentiel, parce que nous en tirons toute la performance sans créer de goulet d’étranglement », résume-t-il.
Six puces conçues ensemble
Nvidia revendique pour cette génération une conception dite extrême en co-ingénierie : six composants pensés dès l’origine pour fonctionner de concert. On y trouve le processeur Vera, le GPU Rubin, un commutateur NVLink de sixième génération, une carte réseau intelligente ConnectX-9, un processeur de traitement de données BlueField-4 et un commutateur Ethernet Spectrum-6.
Dans la configuration NVL72, la plateforme rassemble 72 GPU Rubin et 36 processeurs Vera. Le lien direct entre processeur central et GPU, que Nvidia appelle NVLink-C2C, affiche 1,8 téraoctet par seconde de bande passante cohérente. Le constructeur annonce jusqu’à dix fois plus de débit d’inférence par watt que la génération précédente, et la possibilité d’entraîner de grands modèles avec un quart du nombre de GPU nécessaires sur la plateforme Blackwell.
Un mot d’explication sur ces termes. L’inférence désigne la phase d’utilisation d’un modèle déjà entraîné, celle qui se déclenche à chaque fois que vous posez une question à un assistant. Le débit par watt mesure le nombre de réponses produites pour une consommation électrique donnée. C’est devenu l’indicateur le plus scruté du secteur, tout simplement parce que l’électricité est aujourd’hui le principal facteur limitant des centres de données.
OpenAI attaque le même problème par l’autre bout
Nvidia n’est pas seul à avoir identifié ce goulet d’étranglement. OpenAI a développé sa propre puce, baptisée Jalapeño, avec un objectif comparable mais une méthode inverse.
« Nous avons conçu Jalapeño pour minimiser les mouvements de données et les délais de communication », écrivait l’entreprise dans une publication de blog plus tôt ce mois-ci. « Son large domaine permet à l’intégralité de la charge de travail de rester à l’intérieur d’un seul système connecté, ce qui minimise les déplacements de données et contribue à garder la requête complète rapide et efficace du début à la fin. »
Là où Nvidia optimise la circulation entre composants, OpenAI cherche à supprimer le trajet en enfermant la charge de travail dans une puce unique. Deux philosophies, une même conviction : le gain de performance viendra désormais d’une meilleure gestion du trafic, pas d’un simple ajout de cycles de calcul.
Ce que cela signifie pour la suite
Il serait imprudent d’en conclure que Nvidia a définitivement gagné. Le déplacement de la compétition vers la couche système ne garantit rien : l’entreprise devra affronter les fabricants de puces rivaux et les opérateurs de cloud sur ce terrain comme elle l’a fait sur celui du GPU. Simplement, les règles ont changé. Concevoir un GPU concurrent compte désormais moins que savoir faire fonctionner un système entier avec un rendement maximal.
Pour l’utilisateur final, l’effet est indirect mais réel. Chaque point d’efficacité gagné sur l’orchestration réduit le coût de production d’une réponse générée par IA. C’est ce coût qui détermine, en bout de chaîne, le prix des abonnements, la générosité des offres gratuites et la vitesse à laquelle les fonctions les plus gourmandes descendent vers le grand public.
Un signal supplémentaire mérite d’être noté : la puissance de calcul commence à s’échanger comme un actif financier, le CME ayant lancé des contrats à terme sur ce sous-jacent en août. Quand une ressource devient négociable sur les marchés, c’est généralement le signe qu’elle est devenue une véritable matière première industrielle.
À court terme, Nvidia conserve une avance manifeste sur cette nouvelle couche d’infrastructure. La question intéressante n’est plus de savoir qui fabrique le meilleur GPU, mais qui saura orchestrer des dizaines de milliers de puces sans gaspiller un watt.
Et vous, pensez-vous que l’efficacité énergétique deviendra le vrai critère de comparaison des plateformes d’IA ? Dites-le-nous en commentaire et retrouvez nos analyses matériel sur Wanda-techs.com.
lire aussi:
Share this content:



Laisser un commentaire