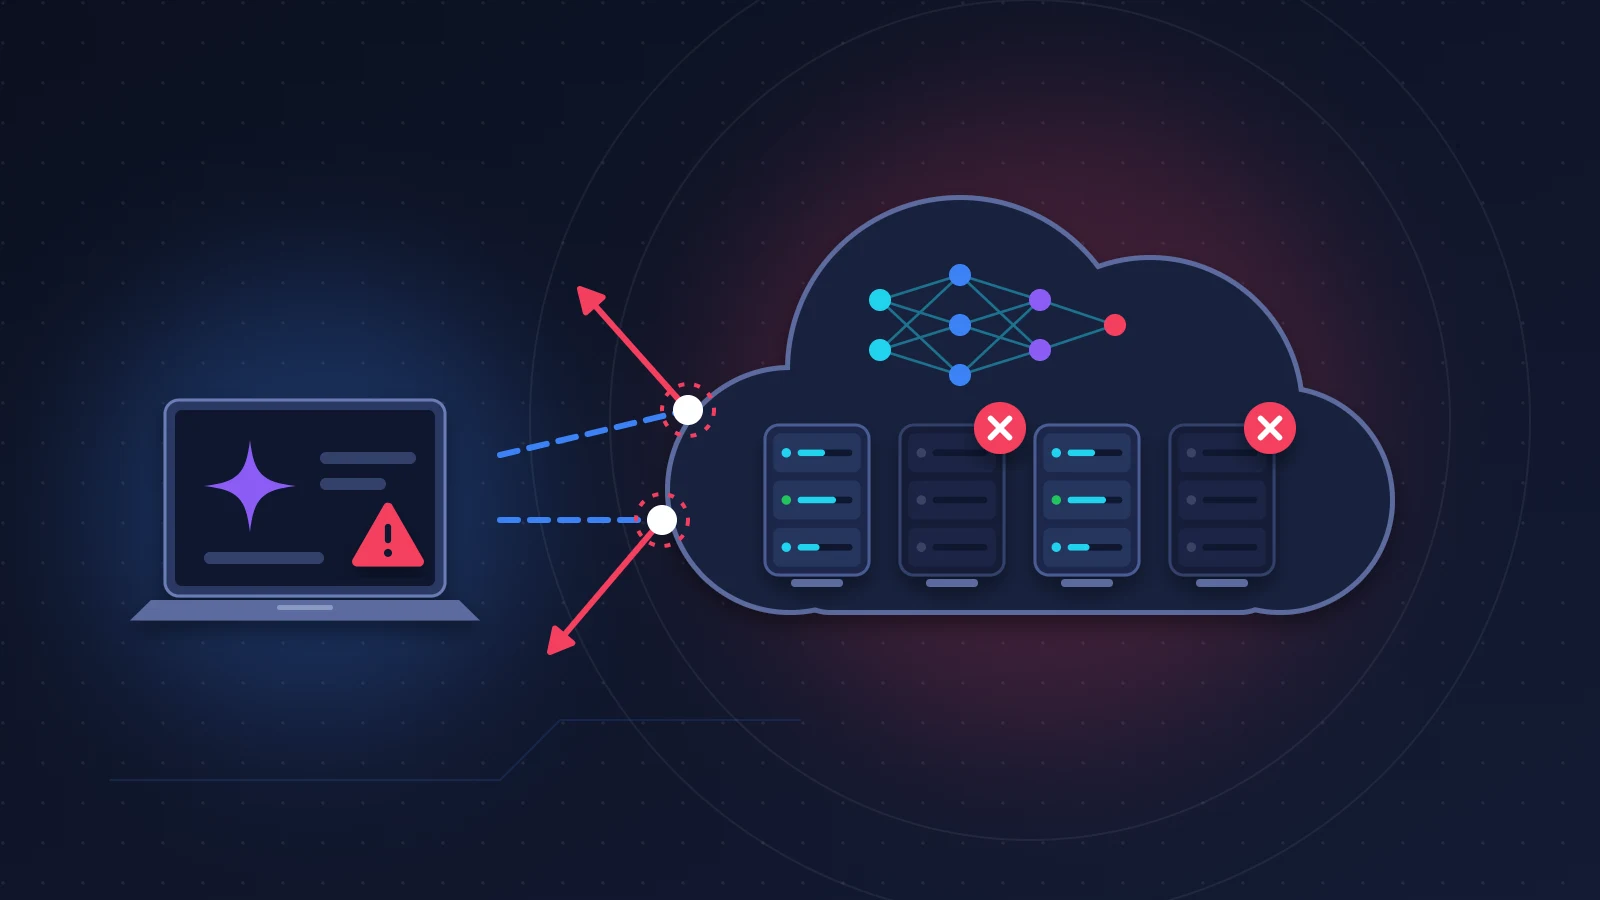
Quando Azure non funziona, non compare quasi mai una bella schermata «servizio non disponibile»: quello che si vede sono chiamate API che falliscono con 429, 500, 503 o 504, risposte tre volte più lente e errori che proseguono anche dopo che la pagina di stato è tornata verde. Prima di mettere mano al codice, verificate lo stato della piattaforma su tre livelli (pagina pubblica, Service Health, Resource Health), poi leggete il codice HTTP e il messaggio di errore: dicono se il problema viene da Microsoft, dalla vostra quota o dalla vostra richiesta. Nella maggior parte dei casi la reazione giusta sta in tre mosse: riprovare con un ritardo crescente e casuale, rispettare l’intestazione retry-after-ms e passare a un secondo deployment se l’attesa richiesta è troppo lunga.
In breve: la soluzione rapida
- Aprite azure.status.microsoft, poi Service Health nel portale di Azure. La pagina pubblica mostra soltanto gli incidenti di grande portata; Service Health mostra ciò che tocca le vostre sottoscrizioni.
- Guardate il codice restituito. 400, 401, 403, 404: il problema è dal vostro lato, riprovare non serve. 429, 500, 502, 503, 504 e timeout: errori transitori, da ritentare con misura.
- Su un 429 leggete il messaggio. «Rate limit is exceeded» indica la vostra quota; «high demand» o «temporarily unable to process» indica la capacità della piattaforma.
- Limitate i tentativi (cinque, non cinquanta), distanziateli in modo esponenziale con una quota di casualità e fissate un timeout breve.
- Se la regione non risponde più, puntate l’applicazione verso un deployment di riserva con un semplice cambio di configurazione.
Riconoscere il problema
Una parte delle richieste passa, un’altra fallisce, senza una logica apparente. I tempi di risposta si allungano prima ancora che compaiano gli errori. I log si riempiono di messaggi di questo genere:
429 Too Many Requests, accompagnato da «Rate limit is exceeded» o «Requests to … have been limited»;429con «The service is temporarily unable to process your request» o «System is experiencing high demand», a volte con il codiceno_capacity;500con un corpo quasi vuoto ("type": "server_error"),502 Bad Gateway,503 Service Unavailable,504 Gateway Timeout;- lato SDK Python:
RateLimitError,InternalServerError,APITimeoutError,APIConnectionError.
Ecco come leggere ciascun codice e se conviene ritentare.
| Codice | Che cosa significa | Riprovare? | Reazione corretta |
|---|---|---|---|
| 400 | Richiesta non valida: parametro errato, contesto troppo lungo, contenuto filtrato | No | Correggere la richiesta |
| 401 / 403 | Chiave non valida, ruolo mancante, firewall o rete privata che blocca | No | Verificare chiave, identità, regole di rete |
| 404 | Nome del deployment o endpoint errato | No | Verificare il nome del deployment, non quello del modello |
| 408 | Il server ha abbandonato una richiesta troppo lenta | Sì | Riprovare con un ritardo; ridurre la dimensione della risposta |
| 429 | Troppe richieste: quota raggiunta, raffica o capacità condivisa satura | Sì | Attendere il tempo indicato da retry-after-ms, poi riprovare |
| 500 | Errore interno del servizio | Sì, poche volte | Backoff con jitter; passare altrove se dura |
| 502 / 504 | Un intermediario (gateway, proxy, bilanciatore) non ha ricevuto una risposta valida o in tempo | Sì | Backoff; attivare lo streaming per le generazioni lunghe |
| 503 | Servizio sovraccarico o non disponibile; restituito anche da un gateway con il circuit breaker aperto | Sì | Backoff, poi passaggio a un altro deployment |
| Timeout, connessione interrotta | La rete o il servizio non rispondono | Sì | Timeout breve, numero di tentativi limitato |
Perché succede
Dietro gli stessi sintomi si nascondono tre cause, e bisogna tenerle distinte.
La prima è un guasto della piattaforma: un difetto di rete, di archiviazione o di calcolo in una o più regioni. Le vostre risorse esistono ancora, ma la strada per raggiungerle è interrotta o rallentata.
La seconda dipende dai vostri limiti. Ogni deployment di Azure OpenAI riceve una portata in token al minuto (TPM) e un numero di richieste al minuto (RPM) che ne deriva. Questi tetti non vengono misurati sul minuto intero: il servizio valuta il ritmo su finestre da uno a dieci secondi. Una raffica inviata nello stesso secondo può far scattare un 429 anche se il totale del minuto resta molto al di sotto della quota. Altra sorpresa documentata da Microsoft: il calcolo tiene conto del valore di max_tokens, non della lunghezza reale della risposta.
La terza è la meno conosciuta. I deployment Standard, fatturati a consumo, attingono a una capacità condivisa tra i clienti. Quando la domanda si avvicina al limite, il servizio abbassa temporaneamente il tetto effettivo di alcuni deployment. Arrivano dei 429 senza che abbiate cambiato nulla. L’indizio si trova nelle intestazioni della risposta: x-ratelimit-limit-tokens riporta un valore inferiore al TPM configurato. Secondo Microsoft, questo aggiustamento rientra in genere nel giro di qualche ora.
Perché gli errori continuano dopo il ripristino ufficiale
«Servizio ripristinato» significa che la causa è stata corretta, non che da voi tutto sia tornato normale. Diversi meccanismi prolungano il disagio.
Al ritorno del servizio, tutti i client che fallivano riprovano nello stesso momento. Questa tempesta di tentativi (retry storm) satura una piattaforma ancora convalescente e produce nuovi 429 e 503. A questo si aggiungono le elaborazioni accumulate nelle code durante l’interruzione, che si riversano tutte insieme. Contano anche le cache DNS: un sistema di instradamento come Traffic Manager lavora a livello di DNS e, finché la durata di validità del record (TTL) non è scaduta, alcuni client continuano a puntare al vecchio indirizzo. I circuit breaker scattati durante l’incidente continuano a bloccare il traffico fino al termine del loro intervallo. Infine, la riduzione temporanea del tetto descritta sopra sopravvive spesso all’incidente stesso.
Prima di cominciare
Non modificate quote, chiavi o regole di rete nel bel mezzo di un incidente: confondereste la diagnosi.
Annotate subito ciò che vi servirà dopo: ora di inizio in UTC, regione, nome del deployment, codici restituiti e qualche identificativo di richiesta preso dalle intestazioni della risposta. Senza questi elementi una richiesta di analisi o di credito non va a buon fine.
Verificate infine di poter cambiare l’endpoint senza rifare il rilascio: una variabile d’ambiente o un servizio di configurazione, mai un indirizzo scritto nel codice.
Soluzione 1: verificare su tre livelli se Azure non funziona davvero
Da fare per prima cosa, senza alcun rischio.
1. La pagina di stato pubblica
Andate su azure.status.microsoft. Offre una vista mondiale per servizio e per regione. Il suo difetto: vi compaiono soltanto gli incidenti estesi, tipicamente quelli che toccano più servizi in un’intera regione. Una pagina tutta verde quindi non dimostra nulla.
2. Service Health nel portale
Nel portale di Azure digitate «Service Health» nella barra di ricerca (in italiano la voce è Integrità dei servizi). La sezione Problemi del servizio (Service issues) elenca gli incidenti che riguardano le vostre sottoscrizioni e le vostre regioni, con un ID di rilevamento e una serie di aggiornamenti. È la fonte a cui credere.
3. Resource Health sulla risorsa
Aprite la risorsa interessata, poi Integrità risorse (Resource health) nel menu a sinistra. Esistono quattro stati: Disponibile (Available), Non disponibile (Unavailable), Danneggiato (Degraded) e Sconosciuto (Unknown). Lo strumento distingue un evento della piattaforma da un evento provocato da un’azione dal vostro lato.
Come verificare: se Service Health segnala un incidente sulla vostra regione e sul vostro servizio, smettete di cercare nel codice e passate alle soluzioni da 3 a 5.
Soluzione 2: distinguere guasto della piattaforma, quota superata ed errore nel codice
Quando non è stato annunciato nulla, fate parlare i dati. In Azure Monitor visualizzate la metrica Azure OpenAI Requests e suddividetela per StatusCode e per ModelDeploymentName.
- Soltanto 4xx diversi da 429, comparsi dopo un rilascio in produzione: il vostro codice o la vostra configurazione.
- 429 su un solo deployment, nelle ore di punta, con il messaggio «Rate limit is exceeded»: quota o raffiche. Riducete
max_tokens, distribuite gli invii, aumentate il TPM del deployment. - 429 «high demand» con un
x-ratelimit-limit-tokensinferiore al vostro TPM: capacità condivisa sotto pressione. - 5xx e timeout su tutti i deployment di una stessa regione: problema della piattaforma, anche se non è ancora stato pubblicato nulla.
Una prova chiude la questione: la stessa chiamata verso un deployment situato in un’altra regione. Se passa, il vostro codice non c’entra.
Soluzione 3: riprovare nel modo giusto, con backoff esponenziale e jitter
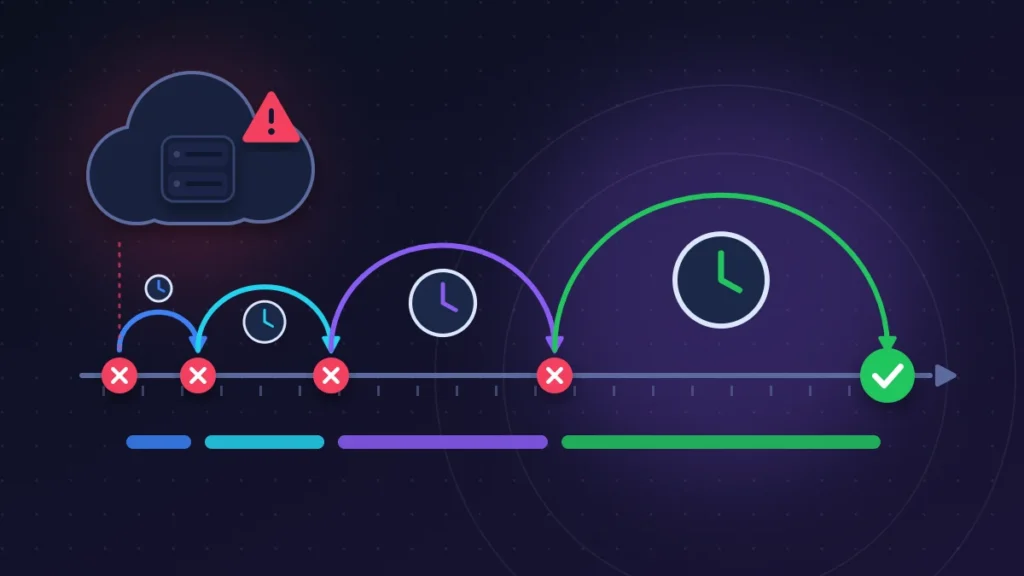
Il correttivo che risolve più casi è anche quello che si scrive più spesso nel modo sbagliato. Il backoff esponenziale consiste nel raddoppiare il ritardo tra un tentativo e il successivo. Il jitter vi aggiunge una componente casuale, per evitare che mille client riprovino nello stesso millisecondo.
L’SDK Python openai riprova già da solo, due volte per impostazione predefinita, sugli errori di connessione, sui 408, 409, 429 e sui codici da 500 in su. Portare max_retries a 5 basta a molte applicazioni. Per governare la logica in prima persona, disattivate i tentativi dell’SDK, altrimenti i due meccanismi si moltiplicano. L’esempio qui sotto è stato eseguito contro un server di prova che restituiva in successione 429, 500, 502, 503 e 504.
import os
import random
import time

import openai
from openai import OpenAI

client = OpenAI(
    base_url=os.environ["AZURE_OPENAI_ENDPOINT"].rstrip("/") + "/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    max_retries=0,  # i tentativi sono gestiti più sotto: niente doppio retry
    timeout=30.0,   # senza questo, l'SDK attende fino a 10 minuti
)

# 429, errori 5xx, timeout e interruzioni di rete: nient'altro
A_REESSAYER = (
    openai.RateLimitError,
    openai.InternalServerError,
    openai.APITimeoutError,
    openai.APIConnectionError,
)


def delai_demande_par_le_serveur(exc):
    """Legge retry-after-ms o retry-after, in secondi. None se assente."""
    reponse = getattr(exc, "response", None)
    if reponse is None:
        return None
    try:
        if "retry-after-ms" in reponse.headers:
            return float(reponse.headers["retry-after-ms"]) / 1000
        if "retry-after" in reponse.headers:
            return float(reponse.headers["retry-after"])
    except ValueError:
        pass
    return None


def appel_resilient(max_tentatives=5, base=1.0, plafond=30.0, **parametres):
    for tentative in range(1, max_tentatives + 1):
        try:
            return client.chat.completions.create(**parametres)
        except A_REESSAYER as exc:
            if tentative == max_tentatives:
                raise
            attente = delai_demande_par_le_serveur(exc)
            if attente is None:
                # backoff esponenziale con jitter: durata estratta a caso
                # tra 0 e un tetto che raddoppia a ogni errore
                attente = random.uniform(0, min(plafond, base * 2 ** (tentative - 1)))
            elif attente > plafond:
                raise  # attesa troppo lunga: meglio passare altrove
            time.sleep(attente)
La chiamata si fa poi con appel_resilient(model="nome-del-deployment", messages=[...]).
Tre trappole. I 400, 401 e 404 non vengono mai ritentati: fallirebbero allo stesso modo. Un retry-after può annunciare un’attesa enorme, fino a un’intera giornata secondo la documentazione di API Management, da cui l’eccezione sollevata oltre il tetto. Infine, ritentate su un solo livello: se la funzione, l’SDK e il gateway riprovano tre volte ciascuno, una richiesta diventa ventisette.
Come verificare: fuori dagli incidenti, il numero medio di tentativi per chiamata deve restare vicino a 1. Se sale, la quota è troppo stretta.
Soluzione 4: timeout, coda e modalità degradata
Il timeout predefinito dell’SDK è di dieci minuti. Durante un guasto questo si traduce in thread bloccati e in un server web che soffoca. Fissate un timeout adatto al vostro caso d’uso e attivate lo streaming (stream=True) per le risposte lunghe: i token arrivano man mano e gli intermediari non chiudono più la connessione per inattività. Molti 504 spariscono così.
Tutto ciò che non richiede una risposta immediata (riassunti, classificazione) deve passare da una coda svuotata a ritmo controllato. Assorbe il guasto e poi si scarica senza raffiche.
Prevedete infine una modalità degradata: una risposta presa da una cache, un modello più leggero o un semplice messaggio onesto che segnala l’indisponibilità momentanea dell’assistente. Un modulo che funziona senza suggerimenti automatici vale più di una pagina di errore.
Soluzione 5: passare a un altro deployment o a un’altra regione
Create in anticipo una seconda risorsa Azure OpenAI in un’altra regione, con lo stesso modello nella stessa versione, e tenetene l’indirizzo nella configurazione. Il passaggio si riduce allora a cambiare una variabile. Tra le due non viene sincronizzato nulla: file e impostazioni devono esistere da entrambe le parti.
Il tipo di deployment conta. Un deployment Global Standard distribuisce il traffico verso i data center disponibili nel mondo; un Data Zone Standard fa lo stesso all’interno di una zona (Stati Uniti o Unione europea, per esempio); uno Standard regionale resta nella propria area geografica. Microsoft consiglia Global Standard quando i vincoli di residenza dei dati lo consentono, Data Zone negli altri casi. Questo instradamento non sostituisce un failover gestito dall’applicazione: il punto di ingresso resta legato a una regione.
Attenzione: le quote Global Standard sono condivise tra le regioni per uno stesso modello all’interno di una sottoscrizione. Due deployment non raddoppiano per forza la portata.
Soluzione 6: un gateway API Management con bilanciamento del carico e circuit breaker
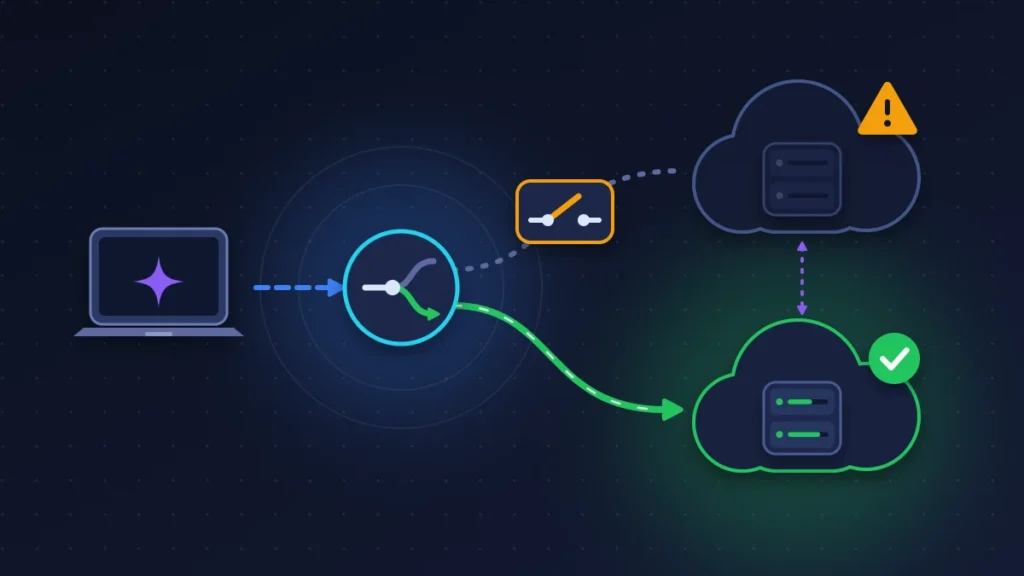
Quando più applicazioni chiamano i modelli, duplicare in ciascuna la logica di failover diventa ingestibile. Azure API Management può fare da gateway: un pool di back-end raggruppa i vostri endpoint, con una distribuzione round robin, ponderata o per priorità.
Il circuit breaker completa il quadro. Si definiscono un numero di errori su un intervallo e una gamma di codici, per esempio 429 e da 500 a 599. Superata la soglia, il gateway smette di inviare traffico a quel back-end per una durata stabilita e serve il successivo. L’opzione acceptRetryAfter allinea questa durata all’intestazione restituita dal servizio. Il circuit breaker non è disponibile nel livello Consumption di API Management ed è ammessa una sola regola per back-end.
Il rovescio della medaglia: il gateway diventa a sua volta un punto di guasto. Con una sola applicazione, un failover scritto lato client costa meno.
Soluzione 7: riservare capacità per i carichi critici
Se il vostro prodotto non tollera né latenze variabili né 429 di capacità, il throughput con provisioning (PTU) riserva potenza di elaborazione per il vostro deployment. Una volta consumate le unità al 100%, il servizio risponde subito 429 con retry-after-ms: è un segnale di regolazione, non un guasto. La funzione di spillover inoltra allora automaticamente l’eccedenza verso un deployment Standard della stessa risorsa, stesso modello e stessa versione.
Tabella riepilogativa
| Sintomo | Causa probabile | Soluzione da provare |
|---|---|---|
| 5xx e timeout su un’intera regione | Guasto della piattaforma | Soluzioni 1, 3 e 5 |
| 429 «Rate limit is exceeded» nelle ore di punta | Quota o raffiche | Ridurre max_tokens, distribuire gli invii, aumentare il TPM |
| 429 «high demand» con quota invariata | Capacità condivisa ridotta | Soluzione 3, poi 5 o 7 |
| 504 sulle generazioni lunghe | Timeout di un intermediario superato | Streaming, risposta più breve |
| Errori che durano dopo il ripristino | Tempesta di tentativi, code, DNS, circuit breaker | Jitter, svuotamento graduale delle code, pazienza |
Se nulla funziona
Aprite una richiesta di supporto dal portale (icona «?», poi Crea una richiesta di supporto, Create a support request). Il supporto tecnico richiede un piano a pagamento; le questioni di fatturazione, di quota e di gestione della sottoscrizione vengono trattate senza piano. Allegate gli elementi annotati in precedenza. Dei 429 duraturi in produzione mentre siete sotto la quota giustificano un’escalation.
Per capire che cosa è successo, aspettate la relazione post-incidente (PIR). Microsoft la pubblica in genere entro due settimane: nella pagina della cronologia di Azure Status per gli incidenti più ampi, in Service Health per i clienti toccati dagli altri.
Il credito di servizio, invece, non viene mai riconosciuto in automatico. Se la disponibilità mensile garantita dal contratto di servizio (SLA) non è stata rispettata, tocca a voi presentare un reclamo al supporto, categoria fatturazione, con la prova dell’impatto: risorse coinvolte, durata, ID di rilevamento dell’incidente. Il reclamo deve arrivare entro un termine limitato dopo il mese dell’incidente. Il credito ha la forma di una percentuale detratta dalla fattura del servizio colpito; non compensa il mancato guadagno.
Evitare che si ripeta
Create un avviso di Service Health: in Service Health, pulsante Crea avviso integrità dei servizi (Create service health alert), scegliete la sottoscrizione, i servizi, le regioni e i tipi di evento, poi un gruppo di azioni (e-mail, SMS, webhook). Microsoft consiglia di selezionare tutti i servizi e tutte le regioni: l’avviso scatta soltanto per ciò che usate davvero. Resource Health richiede una regola a parte.
Aggiungete avvisi sui vostri segnali: tasso di 429, tasso di 5xx, tempi di risposta.
Mettete alla prova il guasto prima che arrivi: in preproduzione iniettate dei 503 con un server fittizio e osservate che cosa fa l’applicazione. Azure Chaos Studio automatizza questo genere di esercizi.
La lista di controllo da tenere a portata di mano:
- endpoint nella configurazione, mai scritto nel codice;
- timeout esplicito su ogni chiamata;
- tentativi limitati, con backoff, jitter e rispetto di
retry-after-ms, su un solo livello; - secondo deployment pronto in un’altra regione, stesso modello, stessa versione;
- coda per le elaborazioni differibili;
- modalità degradata prevista e collaudata;
- avvisi di Service Health e avvisi sui 429 e sui 5xx;
- esercitazione di failover ripetuta ogni trimestre;
- identificativi di richiesta conservati nei log.
Due luoghi comuni per chiudere. Le zone di disponibilità proteggono dal guasto di un data center, non da quello di un’intera regione. E distribuire in una regione abbinata non fa scattare alcun failover automatico: Microsoft lo avvia soltanto in caso di disastro.
Domande frequenti
La pagina di stato di Azure è verde ma le mie chiamate falliscono. È possibile?
Sì. La pagina pubblica riporta soltanto gli incidenti di grande portata. Consultate Service Health nel portale, poi Resource Health sulla risorsa.
Perché ricevo errori 429 se il consumo è lontano dalla quota?
O le richieste arrivano a raffiche in una finestra da uno a dieci secondi, o max_tokens è impostato troppo in alto, o il tetto effettivo del deployment Standard è stato abbassato temporaneamente. Confrontate x-ratelimit-limit-tokens con il TPM configurato.
Quanti tentativi prevedere?
Pochi per un’interfaccia utente, di più per un’elaborazione in background. Microsoft cita un massimo di cinque-dieci sui 429.
Un deployment Global Standard mi dispensa dal multi-region?
No. Microsoft indica che questo instradamento non sostituisce un failover regionale gestito dall’applicazione.
Quando Azure non funziona, chi si è preparato se ne accorge appena: un timeout, tentativi disciplinati e un deployment di riserva bastano a trasformare un’interruzione in un semplice rallentamento. Se avete incontrato un codice di errore che in questa guida manca, o trovato un rimedio che regge in produzione, raccontatelo nei commenti.
Share this content: