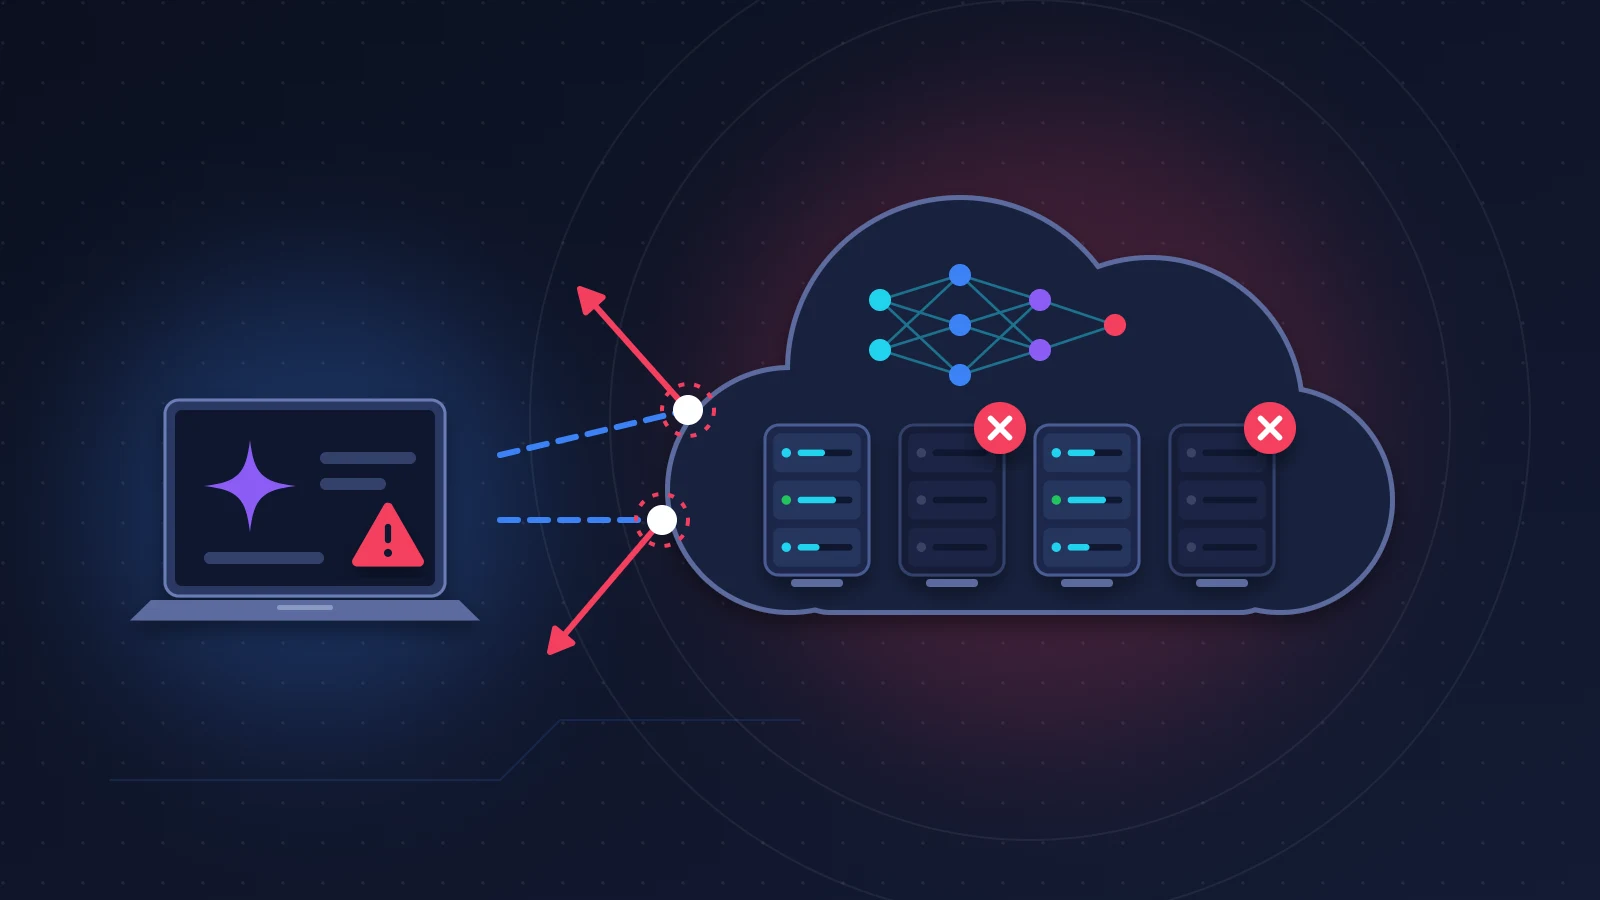
Une panne Azure ne se manifeste presque jamais par un écran « service indisponible » bien net : ce que vous voyez, ce sont des appels API qui échouent en 429, 500, 503 ou 504, des réponses trois fois plus lentes, et des erreurs qui continuent alors que la page d’état est repassée au vert. Avant de toucher à votre code, vérifiez l’état de la plateforme à trois niveaux (page publique, Service Health, Resource Health), puis lisez le code HTTP et le message d’erreur : ils disent si le problème vient de Microsoft, de votre quota ou de votre requête. Dans la majorité des cas, la bonne réaction tient en trois gestes : réessayer avec un délai croissant et aléatoire, respecter l’en-tête retry-after-ms, et basculer sur un second déploiement si l’attente demandée est trop longue.
En bref : la solution rapide
- Ouvrez azure.status.microsoft, puis Service Health dans le portail Azure. La page publique n’affiche que les incidents de grande ampleur ; Service Health montre ce qui touche vos abonnements.
- Regardez le code renvoyé. 400, 401, 403, 404 : le problème est chez vous, réessayer ne sert à rien. 429, 500, 502, 503, 504 et délais dépassés : erreurs passagères, à réessayer avec retenue.
- Sur un 429, lisez le message. « Rate limit is exceeded » désigne votre quota ; « high demand » ou « temporarily unable to process » désigne la capacité de la plateforme.
- Limitez les tentatives (cinq, pas cinquante), espacez-les de façon exponentielle avec une part de hasard, et fixez un délai d’expiration court.
- Si la région ne répond plus, pointez l’application vers un déploiement de secours par simple changement de configuration.
Reconnaître le problème
Une partie des requêtes passe, une autre échoue, sans logique apparente. Le temps de réponse s’allonge avant que les erreurs n’apparaissent. Les journaux se remplissent de messages de ce genre :
429 Too Many Requests, accompagné de « Rate limit is exceeded » ou « Requests to … have been limited » ;429avec « The service is temporarily unable to process your request » ou « System is experiencing high demand », parfois le codeno_capacity;500avec un corps presque vide ("type": "server_error"),502 Bad Gateway,503 Service Unavailable,504 Gateway Timeout;- côté SDK Python :
RateLimitError,InternalServerError,APITimeoutError,APIConnectionError.
Voici comment lire chaque code et s’il faut retenter.
| Code | Ce qu’il signifie | Réessayer ? | Réaction correcte |
|---|---|---|---|
| 400 | Requête invalide : paramètre faux, contexte trop long, contenu filtré | Non | Corriger la requête |
| 401 / 403 | Clé invalide, rôle manquant, pare-feu ou réseau privé qui bloque | Non | Vérifier clé, identité, règles réseau |
| 404 | Nom de déploiement ou point de terminaison erroné | Non | Vérifier le nom du déploiement, pas celui du modèle |
| 408 | Le serveur a abandonné une requête trop lente | Oui | Réessayer avec délai ; réduire la taille de la réponse |
| 429 | Trop de requêtes : quota atteint, rafale, ou capacité partagée saturée | Oui | Attendre la durée indiquée par retry-after-ms, puis réessayer |
| 500 | Erreur interne du service | Oui, peu de fois | Backoff avec jitter ; basculer si cela dure |
| 502 / 504 | Un intermédiaire (passerelle, proxy, équilibreur) n’a pas eu de réponse valable ou à temps | Oui | Backoff ; activer le streaming pour les longues générations |
| 503 | Service surchargé ou indisponible ; aussi renvoyé par une passerelle dont le disjoncteur est ouvert | Oui | Backoff, puis bascule vers un autre déploiement |
| Délai dépassé, connexion coupée | Le réseau ou le service ne répond pas | Oui | Délai d’expiration court, nombre de tentatives borné |
Pourquoi cela se produit
Trois causes se cachent derrière les mêmes symptômes, et il faut les séparer.
La première est une panne de plateforme : un défaut de réseau, de stockage ou de calcul dans une ou plusieurs régions. Vos ressources existent toujours, le chemin pour les atteindre est coupé ou ralenti.
La deuxième tient à vos limites. Chaque déploiement Azure OpenAI reçoit un débit en jetons par minute (TPM) et un nombre de requêtes par minute (RPM) qui en découle. Ces plafonds ne sont pas mesurés sur la minute entière : le service évalue le rythme sur des fenêtres d’une à dix secondes. Une rafale envoyée dans la même seconde peut déclencher un 429 alors que le total de la minute reste très en dessous du quota. Autre surprise documentée par Microsoft : le calcul prend en compte la valeur de max_tokens, pas la longueur réelle de la réponse.
La troisième est la moins connue. Les déploiements Standard, facturés à l’usage, puisent dans une capacité mutualisée entre clients. Quand la demande approche de la limite, le service abaisse temporairement le plafond effectif de certains déploiements. Vous recevez des 429 sans avoir rien changé. L’indice se trouve dans les en-têtes de réponse : x-ratelimit-limit-tokens affiche une valeur inférieure au TPM configuré. D’après Microsoft, cet ajustement se résorbe en général en quelques heures.
Pourquoi les erreurs persistent après le rétablissement officiel
« Service rétabli » signifie que la cause est corrigée, pas que tout est redevenu normal chez vous. Plusieurs mécanismes prolongent la gêne.
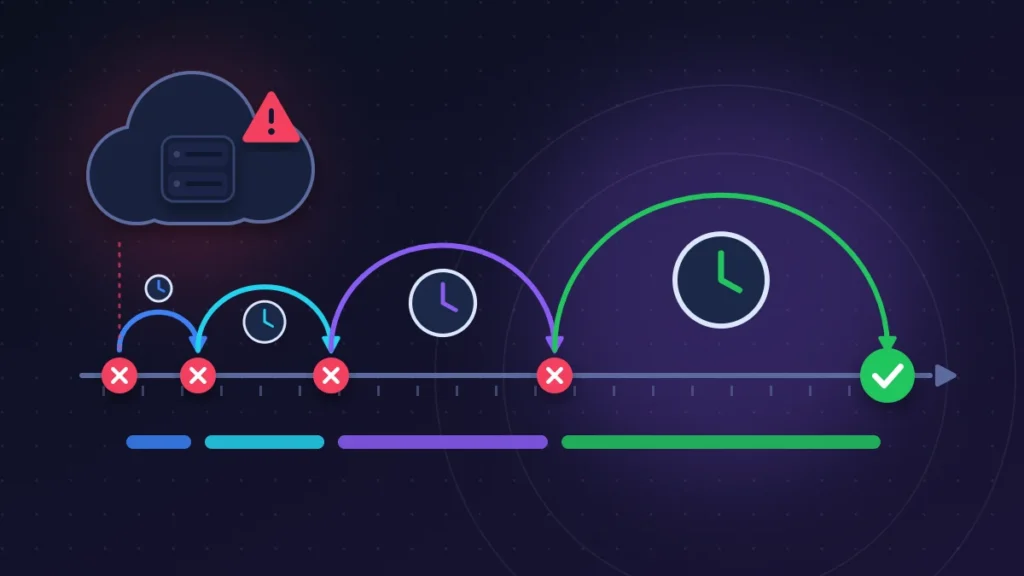
Au retour du service, tous les clients qui échouaient retentent en même temps. Cette tempête de reprises (retry storm) sature une plateforme encore convalescente et produit de nouveaux 429 et 503. S’y ajoutent les traitements accumulés dans les files pendant la coupure, qui se déversent d’un coup. Les caches DNS jouent aussi : un répartiteur comme Traffic Manager travaille au niveau du DNS, et tant que la durée de vie de l’enregistrement (TTL) n’est pas écoulée, certains clients continuent de viser l’ancienne adresse. Les disjoncteurs qui se sont déclenchés pendant l’incident continuent de bloquer le trafic jusqu’à la fin de leur temporisation. Enfin, la réduction temporaire du plafond décrite plus haut survit souvent à l’incident lui-même.
Avant de commencer
Ne modifiez ni vos quotas, ni vos clés, ni vos règles réseau au milieu d’un incident : vous brouilleriez le diagnostic.
Notez tout de suite ce qui vous servira ensuite : heure de début en UTC, région, nom du déploiement, codes renvoyés, et quelques identifiants de requête pris dans les en-têtes de réponse. Sans ces éléments, une demande d’analyse ou de crédit n’aboutit pas.
Vérifiez enfin que vous pouvez changer le point de terminaison sans redéployer : une variable d’environnement ou un service de configuration, jamais une adresse écrite en dur.
Solution 1 : confirmer la panne Azure à trois niveaux
À faire en premier, sans aucun risque.
1. La page d’état publique
Rendez-vous sur azure.status.microsoft. Elle donne une vue mondiale par service et par région. Son défaut : seuls les incidents étendus y figurent, typiquement ceux qui touchent plusieurs services sur une région entière. Une page toute verte ne prouve donc rien.
2. Service Health dans le portail
Dans le portail Azure, tapez « Service Health » dans la barre de recherche. La rubrique Service issues (Problèmes de service) liste les incidents qui concernent vos abonnements et vos régions, avec un identifiant de suivi et un fil de mises à jour. C’est la source à croire.
3. Resource Health sur la ressource
Ouvrez la ressource concernée, puis Resource health dans le menu de gauche. Quatre états existent : Available, Unavailable, Degraded et Unknown. L’outil distingue un événement de plateforme d’un événement provoqué par une action de votre côté.
Comment vérifier : si Service Health annonce un incident sur votre région et votre service, arrêtez de chercher dans votre code et passez aux solutions 3 à 5.
Solution 2 : distinguer panne de plateforme, quota dépassé et erreur de votre code
Quand rien n’est annoncé, faites parler vos données. Dans Azure Monitor, affichez la métrique Azure OpenAI Requests et découpez-la par StatusCode et par ModelDeploymentName.
- Uniquement des 4xx hors 429, apparus après une mise en production : votre code ou votre configuration.
- Des 429 sur un seul déploiement, aux heures de pointe, avec le message « Rate limit is exceeded » : quota ou rafales. Réduisez
max_tokens, lissez les envois, augmentez le TPM du déploiement. - Des 429 « high demand » avec un
x-ratelimit-limit-tokensinférieur à votre TPM : capacité mutualisée sous tension. - Des 5xx et des délais dépassés sur tous les déploiements d’une même région : problème de plateforme, même si rien n’est encore publié.
Un test achève de trancher : le même appel vers un déploiement situé dans une autre région. S’il passe, votre code est hors de cause.
Solution 3 : réessayer correctement, avec backoff exponentiel et jitter
Le correctif qui règle le plus de cas est aussi celui qu’on écrit le plus souvent de travers. Le backoff exponentiel consiste à doubler le délai entre deux tentatives. Le jitter y ajoute une part de hasard, pour éviter que mille clients ne retentent à la même milliseconde.
Le SDK Python openai réessaie déjà seul, deux fois par défaut, sur les erreurs de connexion, les 408, 409, 429 et les codes 500 et plus. Passer max_retries à 5 suffit à beaucoup d’applications. Pour maîtriser la logique vous-même, désactivez les reprises du SDK, sinon les deux mécanismes se multiplient. L’exemple ci-dessous a été exécuté contre un serveur de test renvoyant successivement des 429, 500, 502, 503 et 504.
import os
import random
import time

import openai
from openai import OpenAI

client = OpenAI(
    base_url=os.environ["AZURE_OPENAI_ENDPOINT"].rstrip("/") + "/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    max_retries=0,  # les reprises sont gérées ci-dessous : pas de double retry
    timeout=30.0,   # sans cela, le SDK attend jusqu'à 10 minutes
)

# 429, erreurs 5xx, délais dépassés et coupures réseau : rien d'autre
A_REESSAYER = (
    openai.RateLimitError,
    openai.InternalServerError,
    openai.APITimeoutError,
    openai.APIConnectionError,
)


def delai_demande_par_le_serveur(exc):
    """Lit retry-after-ms ou retry-after, en secondes. None si absent."""
    reponse = getattr(exc, "response", None)
    if reponse is None:
        return None
    try:
        if "retry-after-ms" in reponse.headers:
            return float(reponse.headers["retry-after-ms"]) / 1000
        if "retry-after" in reponse.headers:
            return float(reponse.headers["retry-after"])
    except ValueError:
        pass
    return None


def appel_resilient(max_tentatives=5, base=1.0, plafond=30.0, **parametres):
    for tentative in range(1, max_tentatives + 1):
        try:
            return client.chat.completions.create(**parametres)
        except A_REESSAYER as exc:
            if tentative == max_tentatives:
                raise
            attente = delai_demande_par_le_serveur(exc)
            if attente is None:
                # backoff exponentiel avec jitter : durée tirée au hasard
                # entre 0 et un plafond qui double à chaque échec
                attente = random.uniform(0, min(plafond, base * 2 ** (tentative - 1)))
            elif attente > plafond:
                raise  # attente trop longue : mieux vaut basculer ailleurs
            time.sleep(attente)
L’appel se fait ensuite avec appel_resilient(model="nom-du-deploiement", messages=[...]).
Trois pièges. Les 400, 401 et 404 ne sont jamais retentés : ils échoueraient de la même façon. Un retry-after peut annoncer une attente énorme, jusqu’à une journée selon la documentation d’API Management, d’où la levée d’exception au-delà du plafond. Enfin, ne retentez qu’à un seul étage : si votre fonction, votre SDK et votre passerelle réessaient chacun trois fois, une requête en devient vingt-sept.
Comment vérifier : hors incident, le nombre moyen de tentatives par appel doit rester proche de 1. S’il grimpe, votre quota est trop juste.
Solution 4 : délais d’expiration, file d’attente et mode dégradé
Le délai par défaut du SDK est de dix minutes. Pendant une panne, cela donne des fils d’exécution bloqués et un serveur web qui s’étouffe. Fixez un délai adapté à votre usage, et activez le streaming (stream=True) pour les longues réponses : les jetons arrivent au fil de l’eau et les intermédiaires ne coupent plus la connexion pour inactivité. Beaucoup de 504 disparaissent ainsi.
Tout ce qui n’exige pas de réponse immédiate (résumés, classement) doit passer par une file d’attente dépilée à rythme contrôlé. Elle absorbe la panne, puis se vide sans rafale.
Prévoyez enfin un mode dégradé : réponse issue d’un cache, modèle plus léger, ou simple message honnête indiquant que l’assistant est momentanément indisponible. Un formulaire qui fonctionne sans suggestion automatique vaut mieux qu’une page d’erreur.
Solution 5 : basculer vers un autre déploiement ou une autre région
Créez à l’avance une seconde ressource Azure OpenAI dans une autre région, avec le même modèle dans la même version, et gardez son adresse en configuration. La bascule se résume alors à changer une variable. Rien n’est synchronisé entre les deux : fichiers et réglages doivent exister des deux côtés.
Le type de déploiement compte. Un déploiement Global Standard répartit le trafic vers les centres de données disponibles dans le monde ; un Data Zone Standard fait de même à l’intérieur d’une zone (États-Unis ou Union européenne, par exemple) ; un Standard régional reste dans sa géographie. Microsoft recommande Global Standard quand vos contraintes de résidence des données le permettent, Data Zone sinon. Ce routage ne remplace pas une bascule gérée par votre application : le point d’entrée reste rattaché à une région.
Attention : les quotas Global Standard sont partagés entre régions pour un même modèle au sein d’un abonnement. Deux déploiements ne doublent pas forcément votre débit.
Solution 6 : une passerelle API Management avec répartition de charge et disjoncteur
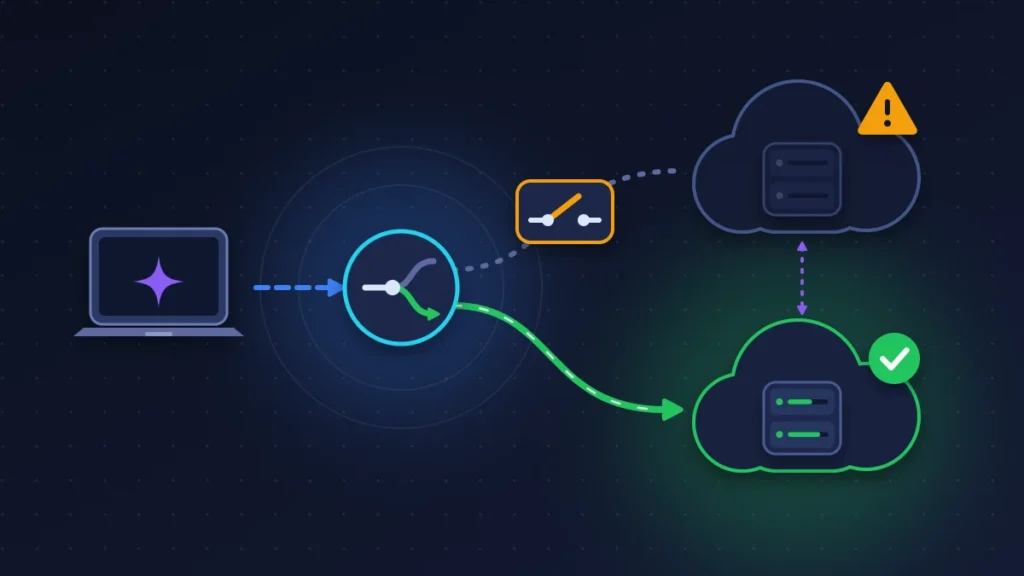
Quand plusieurs applications appellent les modèles, dupliquer la logique de bascule dans chacune devient ingérable. Azure API Management peut jouer le rôle de passerelle : un pool de backends regroupe vos points de terminaison, avec une répartition en tourniquet, pondérée ou par priorité.
Le disjoncteur (circuit breaker) complète le dispositif. Vous définissez un nombre d’échecs sur un intervalle et une plage de codes, par exemple 429 et 500 à 599. Le seuil franchi, la passerelle cesse d’envoyer du trafic vers ce backend pendant une durée donnée et sert le suivant. L’option acceptRetryAfter cale cette durée sur l’en-tête renvoyé par le service. Le disjoncteur n’est pas disponible dans le niveau Consumption d’API Management, et une seule règle est admise par backend.
Revers de la médaille : la passerelle devient elle-même un point de défaillance. Avec une seule application, une bascule codée côté client coûte moins cher.
Solution 7 : réserver de la capacité pour les charges critiques
Si votre produit ne supporte ni latence variable ni 429 de capacité, le débit provisionné (PTU) réserve une puissance de traitement pour votre déploiement. Une fois les unités consommées à 100 %, le service répond aussitôt 429 avec retry-after-ms : c’est un signal de régulation, pas une panne. La fonction de débordement (spillover) renvoie alors automatiquement l’excédent vers un déploiement Standard de la même ressource, même modèle et même version.
Tableau récapitulatif
| Symptôme | Cause probable | Solution à essayer |
|---|---|---|
| 5xx et délais dépassés sur toute une région | Panne de plateforme | Solutions 1, 3 et 5 |
| 429 « Rate limit is exceeded » aux heures de pointe | Quota ou rafales | Réduire max_tokens, lisser, augmenter le TPM |
| 429 « high demand » avec quota inchangé | Capacité mutualisée réduite | Solution 3, puis 5 ou 7 |
| 504 sur les longues générations | Délai d’un intermédiaire dépassé | Streaming, réponse plus courte |
| Erreurs qui durent après le rétablissement | Tempête de reprises, files, DNS, disjoncteurs | Jitter, vidage progressif des files, patience |
Si rien ne fonctionne
Ouvrez une demande de support depuis le portail (icône « ? », puis Create a support request). Le support technique exige un plan payant ; les questions de facturation, de quota et de gestion d’abonnement sont traitées sans plan. Joignez les éléments notés plus haut. Des 429 durables en production alors que vous êtes sous votre quota justifient une escalade.
Pour comprendre ce qui s’est passé, attendez le rapport post-incident (PIR). Microsoft le publie en général dans les deux semaines : sur la page d’historique d’Azure Status pour les incidents les plus larges, dans Service Health pour les clients touchés par les autres.
Le crédit de service, lui, n’est jamais versé automatiquement. Si la disponibilité mensuelle garantie par le contrat de niveau de service (SLA) n’a pas été tenue, c’est à vous de déposer une réclamation auprès du support, catégorie facturation, avec la preuve de l’impact : ressources concernées, durée, identifiant de suivi de l’incident. La réclamation doit arriver dans un délai limité après le mois de l’incident. Le crédit prend la forme d’un pourcentage déduit de la facture du service touché ; il ne compense pas votre manque à gagner.
Éviter que cela se reproduise
Créez une alerte Service Health : dans Service Health, bouton Create service health alert, choisissez l’abonnement, les services, les régions et les types d’événements, puis un groupe d’actions (e-mail, SMS, webhook). Microsoft conseille de cocher tous les services et toutes les régions : l’alerte ne se déclenche que pour ce que vous utilisez. Resource Health demande sa propre règle.
Ajoutez des alertes sur vos propres signaux : taux de 429, taux de 5xx, temps de réponse.
Testez la panne avant qu’elle n’arrive : en préproduction, injectez des 503 avec un faux serveur et regardez ce que fait l’application. Azure Chaos Studio automatise ce genre d’exercice.
La check-list à garder sous la main :
- point de terminaison en configuration, jamais en dur ;
- délai d’expiration explicite sur chaque appel ;
- reprises bornées, avec backoff, jitter et respect de
retry-after-ms, à un seul étage ; - second déploiement prêt dans une autre région, même modèle, même version ;
- file d’attente pour les traitements différables ;
- mode dégradé prévu et testé ;
- alertes Service Health et alertes sur les 429 et 5xx ;
- exercice de bascule répété chaque trimestre ;
- identifiants de requête conservés dans les journaux.
Deux idées reçues pour finir. Les zones de disponibilité protègent d’une défaillance de centre de données, pas de celle d’une région entière. Et déployer dans une région jumelée ne déclenche aucune bascule automatique : Microsoft ne la provoque qu’en cas de catastrophe.
Questions fréquentes
La page d’état Azure est verte mais mes appels échouent. Est-ce possible ?
Oui. La page publique ne recense que les incidents de grande ampleur. Consultez Service Health dans le portail, puis Resource Health sur la ressource.
Pourquoi ai-je des erreurs 429 alors que ma consommation est loin du quota ?
Soit vos requêtes arrivent en rafales sur une fenêtre d’une à dix secondes, soit max_tokens est réglé trop haut, soit le plafond effectif de votre déploiement Standard a été abaissé temporairement. Comparez x-ratelimit-limit-tokens à votre TPM configuré.
Combien de tentatives prévoir ?
Peu pour une interface utilisateur, davantage pour un traitement de fond. Microsoft cite un maximum de cinq à dix sur les 429.
Un déploiement Global Standard me dispense-t-il du multi-région ?
Non. Microsoft indique que ce routage ne remplace pas une bascule régionale gérée par l’application.
Une panne Azure se prépare bien plus qu’elle ne se subit : un délai d’expiration, des reprises disciplinées et un déploiement de secours suffisent à transformer une interruption en simple ralentissement. Si vous avez rencontré un code d’erreur absent de ce guide ou trouvé une parade qui tient en production, racontez-le en commentaire.
Share this content: