Nvidia: con Vera Rubin il vantaggio si sposta oltre la GPU
Da tre anni la narrazione dominante su Nvidia stava in una riga: l’azienda vendeva le uniche schede grafiche capaci di far girare l’IA su larga scala, e quell’esclusiva valeva oro. Poi i giganti del cloud hanno iniziato a progettare i propri chip, e gli investitori si sono chiesti quanto sarebbe durato il vantaggio. Dalla pubblicazione dei risultati trimestrali del gruppo, mercoledì scorso, si impone una lettura diversa: il vero fossato scavato da Nvidia non sta più nella GPU in sé, ma in tutto ciò che le sta attorno. Vediamo perché.
La GPU non è più l’unico terreno di gioco
Prima una definizione. Una GPU (unità di elaborazione grafica) è un chip nato per i videogiochi, la cui architettura massicciamente parallela si è rivelata ideale per addestrare e far funzionare reti neurali. È questo componente ad aver decuplicato la valutazione di Nvidia tra l’inizio del 2023 e la metà del 2025.
Da un anno la traiettoria di borsa è nettamente più calma. Il motivo è noto: Amazon, Google e altri operatori di data center progettano ormai i propri acceleratori, e la concorrenza sul silicio puro si intensifica. La domanda del mercato era quindi legittima: che cosa resta a Nvidia quando la GPU diventa una merce come le altre?
La risposta sta in una parola poco spettacolare ma decisiva: orchestrazione. Quando un data center raggiunge la scala del gigawatt, farlo funzionare al massimo rendimento diventa un problema ingegneristico ben più complesso della potenza di calcolo grezza.
Vera Rubin, ovvero l’auto intera e non solo il motore
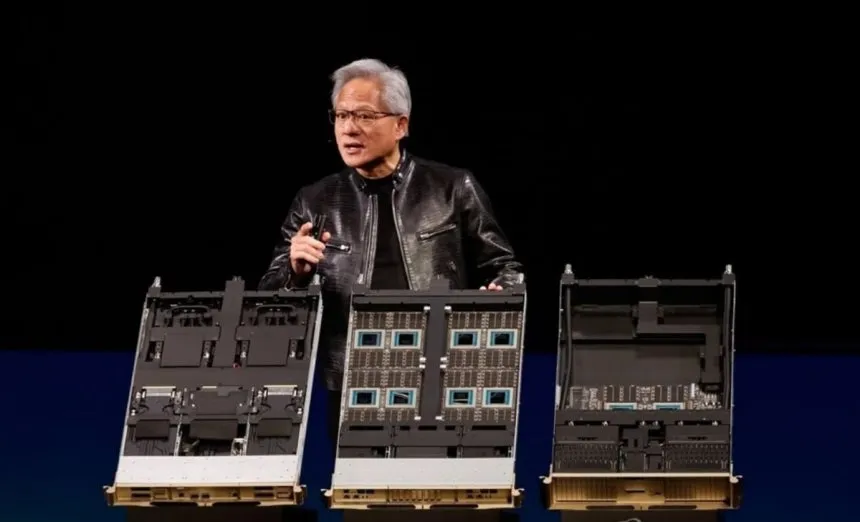
Nvidia sta attualmente distribuendo la propria architettura Vera Rubin. Il nome copre molto più di un processore: abbina la GPU Rubin a un insieme di unità specializzate, tra cui il processore centrale Vera, un acceleratore di inferenza che il costruttore chiama LPX, oltre a rack dedicati ad archiviazione e rete.
La metafora usata da TechCrunch è efficace: se la GPU è il motore, questi elementi sono il resto dell’automobile. Non macinano token di calcolo, si assicurano che tutto ciò che gravita attorno alla GPU funzioni senza sprechi.
Il processore Vera illustra perfettamente questa logica. La sua funzione principale non è calcolare ma dirigere la circolazione dei dati. “Vera è importante perché c’è solo una certa quantità di memoria che si può installare in un singolo server, o in qualsiasi piattaforma di calcolo”, spiega Jason Hardy, vicepresidente per le tecnologie di archiviazione di Nvidia.
Il problema è concreto. La capacità di memoria dei data center è cresciuta al passo con la potenza di calcolo, il che ha arricchito i produttori di memorie durante la seconda ondata del boom infrastrutturale. Ma disporre del dato non basta: occorre portarlo alla GPU al momento giusto. Altrimenti un processore fatturato decine di migliaia di dollari passa parte del tempo ad aspettare.
Secondo Jason Hardy, l’accelerazione offerta dal processore Vera arriva fino a tre volte su queste operazioni di instradamento. “Ora possiamo sfruttare la nostra memoria flash al massimo potenziale, perché ne otteniamo tutte le prestazioni senza creare colli di bottiglia”, riassume.
Sei chip progettati insieme
Per questa generazione Nvidia rivendica una progettazione congiunta definita estrema: sei componenti pensati fin dall’origine per lavorare in sinergia. Vi figurano il processore Vera, la GPU Rubin, uno switch NVLink di sesta generazione, una scheda di rete intelligente ConnectX-9, un’unità di elaborazione dati BlueField-4 e uno switch Ethernet Spectrum-6.
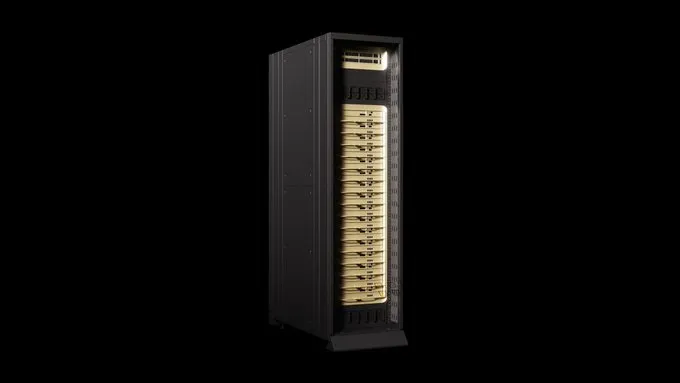
Nella configurazione NVL72 la piattaforma riunisce 72 GPU Rubin e 36 processori Vera. Il collegamento diretto tra processore centrale e GPU, che Nvidia chiama NVLink-C2C, offre 1,8 terabyte al secondo di banda coerente. Il costruttore annuncia fino a dieci volte il throughput di inferenza per watt rispetto alla generazione precedente, e la possibilità di addestrare grandi modelli con un quarto delle GPU necessarie sulla piattaforma Blackwell.
Una precisazione sui termini. L’inferenza indica la fase di utilizzo di un modello già addestrato, quella che si attiva ogni volta che ponete una domanda a un assistente. Il throughput per watt misura quante risposte vengono prodotte a parità di consumo elettrico. È diventato l’indicatore più osservato del settore, semplicemente perché l’energia è oggi il principale fattore limitante dei data center.
OpenAI affronta lo stesso problema dall’altro capo
Nvidia non è l’unica ad aver individuato questo collo di bottiglia. OpenAI ha sviluppato il proprio chip, chiamato Jalapeño, con un obiettivo simile ma un metodo opposto.
“Abbiamo progettato Jalapeño per ridurre al minimo gli spostamenti di dati e i ritardi di comunicazione”, scriveva l’azienda in un post sul blog all’inizio di questo mese. “Il suo ampio dominio permette all’intero carico di lavoro di restare all’interno di un unico sistema connesso, riducendo al minimo gli spostamenti di dati e contribuendo a mantenere l’intera richiesta rapida ed efficiente dall’inizio alla fine.”
Dove Nvidia ottimizza la circolazione tra componenti, OpenAI cerca di eliminare il tragitto racchiudendo il carico di lavoro in un chip unico. Due filosofie, una stessa convinzione: il guadagno di prestazioni verrà ormai da una migliore gestione del traffico, non da un semplice aumento dei cicli di calcolo.
Che cosa significa per il futuro
Sarebbe imprudente concluderne che Nvidia ha vinto definitivamente. Lo spostamento della competizione verso il livello di sistema non garantisce nulla: l’azienda dovrà affrontare i produttori di chip rivali e gli operatori cloud su questo terreno come ha fatto su quello delle GPU. Semplicemente, le regole sono cambiate. Progettare una GPU concorrente conta ormai meno che saper far funzionare un intero sistema al massimo rendimento.
Per l’utente finale l’effetto è indiretto ma reale. Ogni punto di efficienza guadagnato sull’orchestrazione riduce il costo di produzione di una risposta generata dall’IA. È quel costo a determinare, a valle, il prezzo degli abbonamenti, la generosità delle offerte gratuite e la velocità con cui le funzioni più esigenti scendono verso il grande pubblico.
Un ulteriore segnale merita attenzione: la potenza di calcolo comincia a essere scambiata come un attivo finanziario, con il CME che ad agosto ha lanciato contratti futures su questo sottostante. Quando una risorsa diventa negoziabile sui mercati, di solito è il segno che è diventata una vera materia prima industriale.
Nel breve termine Nvidia conserva un vantaggio evidente su questo nuovo strato infrastrutturale. La domanda interessante non è più chi costruisce la GPU migliore, ma chi saprà orchestrare decine di migliaia di chip senza sprecare un watt.
Secondo voi l’efficienza energetica diventerà il vero criterio di confronto tra le piattaforme di IA? Scrivetecelo nei commenti e seguite le nostre analisi hardware su Wanda-techs.com.
Leggi anche:
Share this content:


Commento all'articolo